El “Ozempic” de la inteligencia artificial: desarrollan una tecnología para achicar los modelos y reducir su consumo energético

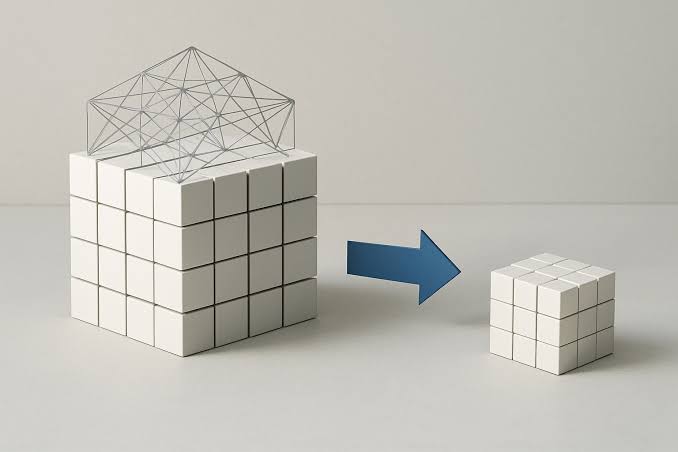
Una empresa europea creó una tecnología capaz de comprimir grandes modelos de IA para que ocupen menos espacio, necesiten menos hardware y consuman menos energía. En algunos casos reportó reducciones de tamaño superiores al 90%.
La carrera por desarrollar modelos de inteligencia artificial cada vez más grandes tiene un problema: cuanto más crecen, mayores son las necesidades de procesadores, memoria, centros de datos y energía.
Una empresa europea intenta recorrer el camino contrario.
Multiverse Computing desarrolló CompactifAI, una tecnología que busca comprimir grandes modelos de inteligencia artificial eliminando parte de sus redundancias matemáticas y reduciendo la cantidad de recursos necesarios para utilizarlos.
Sus responsables la comparan con una especie de “Ozempic de la inteligencia artificial”: en lugar de seguir aumentando indefinidamente el tamaño de los modelos, intenta hacerlos más pequeños y eficientes.
Según Román Orús, cofundador y director científico de Multiverse Computing, la compañía consiguió en determinados casos reducciones superiores al 90% y de hasta el 97% en el tamaño de los modelos, mientras que el consumo energético puede caer aproximadamente a la mitad o incluso por debajo. Orús señaló además pérdidas de precisión del orden del 3% al 4% en esos casos.
No significa, sin embargo, que todos los modelos puedan reducirse un 97% manteniendo exactamente esas prestaciones. Los resultados dependen del modelo, la tarea, el hardware y el grado de compresión.
¿Cómo funciona?
CompactifAI utiliza técnicas matemáticas basadas, entre otras herramientas, en redes tensoriales para reducir la cantidad de parámetros y recursos necesarios por los modelos.
La idea consiste en detectar redundancias dentro de enormes estructuras matemáticas y representar parte de esa información de una forma más compacta.
El resultado buscado es una IA que necesite menos memoria, menos almacenamiento y menor capacidad computacional.
Esto podría tener una consecuencia particularmente importante: ejecutar modelos avanzados sin depender necesariamente de enormes cantidades de GPU.
En julio, Multiverse presentó pruebas con una versión comprimida de Llama 3.3 70B ejecutada sobre procesadores Intel Xeon 6.
En ese ensayo concreto, el modelo pasó de ocupar aproximadamente 130 GiB a 65 GiB, una reducción cercana al 50%. Al mismo tiempo, prácticamente duplicó algunas métricas de rendimiento y redujo cerca de la mitad determinadas mediciones de latencia.
La precisión se mantuvo en más del 97% de la obtenida por el modelo original en el conjunto de pruebas publicado por la compañía.
IA sin depender exclusivamente de las GPU
El desarrollo también apunta a otro cuello de botella de la industria: los chips especializados.
Multiverse anunció esta semana que una versión optimizada de Whisper puede realizar tareas empresariales de reconocimiento de voz utilizando únicamente CPU convencionales, sin aceleradores discretos. La compañía sostiene que esa implementación puede duplicar el rendimiento y procesar unas 17.000 horas de audio por día en un servidor estándar.
Qualcomm también confirmó que trabaja con Multiverse para combinar CompactifAI con su infraestructura Dragonfly. El objetivo es reducir los requerimientos de memoria y permitir que los centros de datos ejecuten más modelos dentro de la misma infraestructura y del mismo límite energético.
El tamaño empieza a convertirse en un problema
Durante los primeros años de la explosión de la inteligencia artificial generativa, buena parte de la competencia tecnológica estuvo concentrada en aumentar el tamaño y la capacidad de los modelos.
Pero esa estrategia tiene costos.
Modelos mayores requieren enormes cantidades de memoria y capacidad computacional, además de una infraestructura cada vez más costosa para entrenarlos y ejecutarlos.
La alternativa comienza a ser una inteligencia artificial más especializada: modelos más pequeños destinados a tareas concretas que puedan funcionar en servidores convencionales, computadoras personales o dispositivos ubicados en el propio lugar donde se generan los datos.
Eso también podría tener implicancias para la privacidad.
Un modelo suficientemente pequeño puede ejecutarse localmente, sin necesidad de enviar permanentemente información hacia servidores externos. Multiverse señala precisamente la posibilidad de desplegar sus modelos en nubes privadas, instalaciones propias de las empresas o dispositivos locales.
La próxima competencia de la inteligencia artificial, por lo tanto, podría no definirse solamente por quién construye el modelo más grande, sino también por quién consigue hacer funcionar modelos avanzados utilizando menos chips, menos memoria, menos energía y menos dinero.